11月13日晚上,DeepSeek 悄无声息地发了一份技术公告,没有新模型跑分,没有发布会直播,却让大洋彼岸恨得牙痒痒。
这一次,DeepSeek干了一件违背过去二十年互联网祖训的事:
它抄起手术刀,把自己引以为傲的国民级App“大卸八块”,然后把心肝脾肺肾摆在柜台上,按斤论两往外批发。
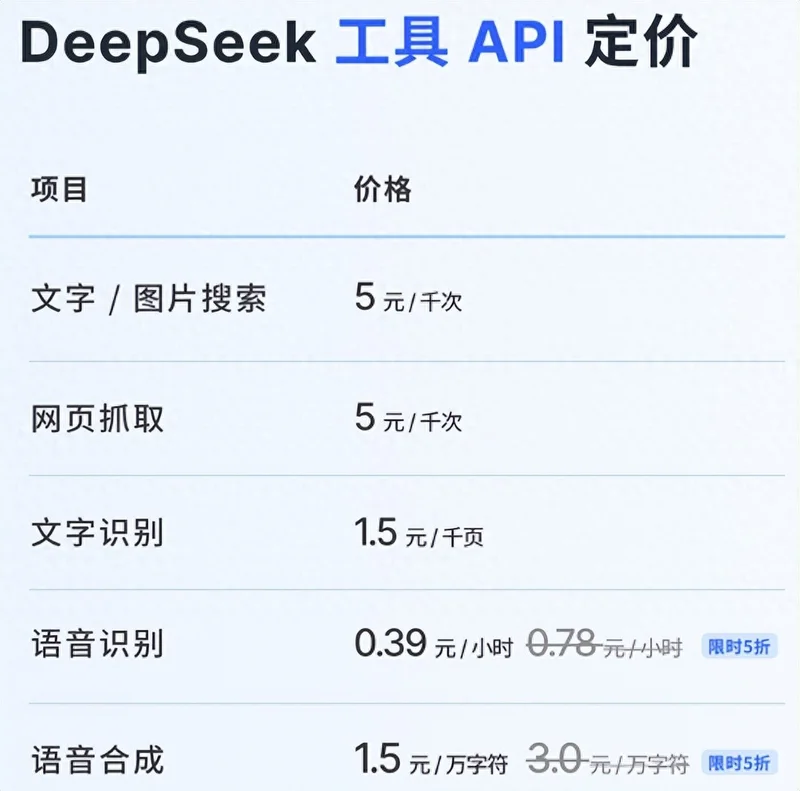
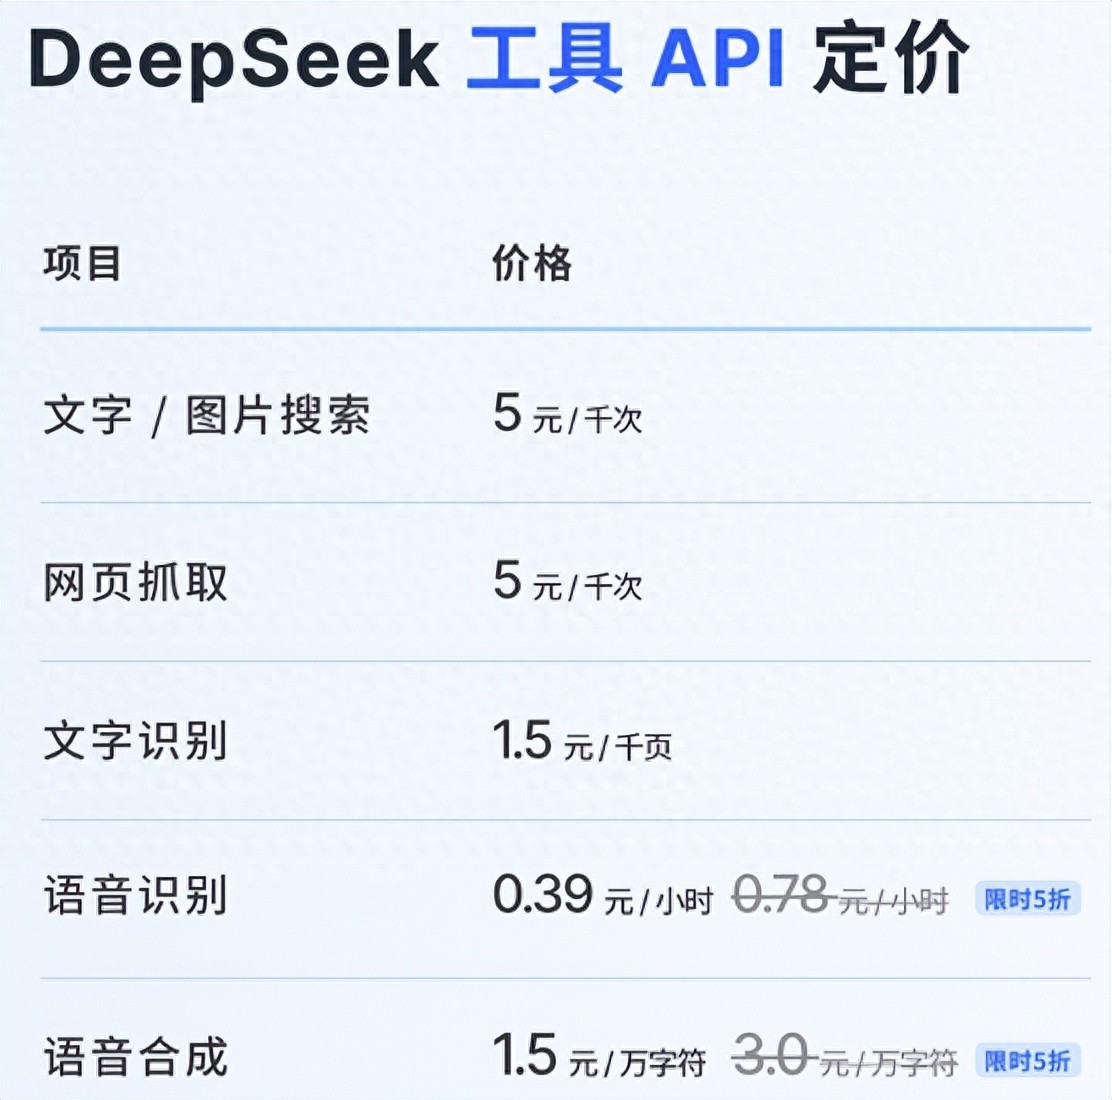
网盘搜索,5块钱1000次,折合一次半分钱;
网页抓取,同样半分钱一次;
OCR文档识别,1.5元1000页,一页只要一厘五;
语音识别,限时特惠每小时3毛9。
最离谱的是,交完这笔近乎“废品回收价”的工具费之后,DeepSeek 顺手在 GitHub 上用最宽松的MIT协议,把自家的前端聊天界面也开源了。
甚至他们还贴心地支持一键导入官方App的历史聊天记录。
翻译成大白话就是:
“我家厨房的秘制酱料、切好的净菜、甚至连店面装修图纸都白送你了,你花五分钟就能在街对面开一家和我一模一样的店。”
在传统互联网的丛林法则里,大厂恨不得把每一个功能都焊死在自家超级App的“围墙花园”里,生怕用户多看一眼外面的世界。
DeepSeek 却亲手拆掉了自家的承重墙。这到底是技术极客的浪漫主义上头,还是一场筹划了整整三年的商业阳谋?
 DeepSeek 联网搜索
掀翻“微软搜索税”的桌子,半分钱背后的三年暗战
要看懂这“半分钱一次搜索”的杀伤力,得先把时钟拨回2023年2月。那时候 ChatGPT 刚刚引爆全球,硅谷无数创业公司涌入 AI 搜索赛道。
结果大家很快绝望地发现,互联网过去二十年有个公开的秘密:
从零抓取全球网页、建立千亿级索引,是一个纯粹的无底洞,全世界只有谷歌和微软必应等极少数巨头玩得起。
哪怕是当时估值数亿美元的 AI 搜索明星 Perplexity,或是由前谷歌广告高管创立的独立搜索引擎 Neeva,底层都得乖乖向微软购买 Bing Search API。
微软也精明得很。
一看你们都在拿我的搜索结果喂大模型,2023年2月,微软突然挥起屠刀,将 Bing 搜索接口的价格暴涨3倍到10倍(最高涨幅高达1000%)。
三个月后,烧不起钱的 Neeva 黯然宣布关闭消费者业务,全球所有 AI 应用被迫背上了沉重的“微软搜索税”。
 Neeva 两位联合创始人
直到今天,海外主流 Agent 搜索接口 Tavily 依然要卖到约8美元一千次,Anthropic 的内置搜索更是高达10美元一千次——折合人民币七十多块钱。
很多人一直以为,DeepSeek 联网搜索的背后也是转接了某家传统搜索引擎的接口。
直到这次技术文档公开,行业才惊觉:
DeepSeek 竟然在过去两年里,硬生生从零自建了一套覆盖全球千亿级网页、日均处理数亿次请求的 AI 原生搜索引擎。
它为什么要干这种又苦又累的基建重活?因为传统搜索引擎是为“人类点链接、看广告”设计的,里面塞满了 SEO 垃圾农场和专门针对大模型投毒的作弊网页。
DeepSeek 自己下场写爬虫、建索引、做去噪清洗,等到自家 App 每天几亿次的搜索量把服务器成本摊平后,对外喊出“5元千次”(不到 Anthropic 价格的十三分之一),依然游刃有余。
当别人还在交“搜索税”的时候,梁文锋的团队已经把自来水厂修到了水源头。
 微软 Bing 数据中心
把“炼丹炉的副产品”论斤卖,顺手消灭“HTML税”
如果说搜索引擎是硬骨头,那这次同步放出的 OCR、网页抓取和语音全家桶,则暴露了 DeepSeek 极致的工程算计。在 11月13日之前,开发者哪怕接上了顶级大模型 API,想做出一个好用的 AI 助手依然痛苦不堪。
这就像你想开一家米其林餐厅,好不容易请到了顶级大厨(大模型),结果发现后厨连菜都没洗——你得去东市买搜索引擎,去西市买 PDF 识别,去南市买语音转写,回来自己写几千行代码把它们硬凑在一起。
更要命的是行业里臭名昭著的“HTML税”。普通网页的源代码里,有超过 70% 都是导航栏、广告脚本和网页样式废话。
开发者直接把网页抓回来塞给大模型,模型光读这些乱码就会吃掉几万个 Token,既慢又贵还容易产生幻觉。
现在 DeepSeek 直接把自家旗舰 App 打磨成熟的“配菜流水线”搬到了云端,推出了“免洗净菜包”。
开发者只要在对话接口里打开一个参数,搜索、深度阅读、文件解析、上下文拼接全在 DeepSeek 服务端自动完成;抓回来的网页直接帮你剔除掉所有广告代码,清洗成干干净净的纯文本再喂给模型。
更绝的是它的计费规矩:
不像某些云厂商按“敲锤子次数”算钱,哪怕搜出一堆空白页面也要扣费;DeepSeek 规定只有返回成功且结果非空的请求才计费,超时、失败、搜不到一律一分钱不收。
至于那个令人瞠目结舌的 1.5元/千页 OCR(海外同类标杆 Mistral OCR 卖到 14 到 29 元人民币),说穿了更是“降维打击”。
 DeepSeek-OCR
大模型训练需要海量高密度知识,而人类最精华的论文、年报、教材全锁在扫描版 PDF 里。
DeepSeek 过去两年为了给自家模型“炼丹”,内部早就建起了一座处理过几十亿页文献的超大规模数据清洗工厂,甚至在2025年开源过利用“光学上下文压缩”技术把密集文字压成视觉 Token 的黑科技。
研发成本早就在训练主模型时摊销完了,如今开放 API,不过是把炼丹炉里富余的产能顺手拿出来变现。
把这些冷冰冰的 B 端参数换算成普通人的日常账单,画面就更魔幻了:
一个考研党在期末周,把一本 800 页的扫描版《病理学》教材转成可检索、可让 AI 划重点的电子文档,成本只要 1块2毛钱;
一个外企打工人每周开 10 个小时的跨国长会,全套录音转文字,一周只要 3块9毛钱,还不够买一瓶无糖乌龙茶;
一部 10 万字的网文小说,用语音合成全本朗读成有声书,全部成本只要 20-30 块钱。
可想而知,此刻应用商店里那些靠“调三个接口包一层壳”、然后向普通人收 38 元甚至 98 元一个月会员费的“AI 会议纪要”、“AI 论文神器”,后台老板们估计正在连夜改商业计划书:
上游原料商突然在街口摆摊,把一模一样的茶底和鲜奶按五毛钱一份直接卖给路人,中间商的好日子到头了。
 DeepSeek-OCR 2 识别数学教材
看似“慈善大甩卖”,实则是一场筹划三年的阳谋
千万别被“半分钱”的表象迷惑,以为 DeepSeek 是一家不计成本做慈善的技术理想主义机构。把时间线拉长到三年,你会看到一套极其老辣的商业组合拳。2024年5月,DeepSeek-V2 率先把推理价格打到“1元/百万Tokens”,逼得国内大厂连夜跟进;
2025年初,V3 与 R1 以极低训练成本引爆全球,拿下了海量开发者心智;
可就在三个月前的 2026年8月,DeepSeek 突然杀了一个“回马枪”:发布重型推理模型 V4-Pro 并恢复峰谷分时定价,把高峰期输出价格一口气暴涨了 350%,当时媒体一片惊呼“DeepSeek 开始算账盈利了”。
 梁文锋
那是他们在清洗低价值羊毛党,死死守住高端算力的利润率。
紧接着,10月推出 V4.1-Flash,把缓存命中输入价格压到近乎白送的 0.02元/百万Tokens;11月13日,再抛出“全家桶应用 API”与开源前端。
这是一场教科书级别的“剃须刀 + 刀片”逆向护城河之战。算一笔全链路总账:
如今用 DeepSeek 跑一次包含 3 次联网搜索、2 次深度读全文、2 万上下文输入并生成 2000 字长文的深度调研任务,算上所有工具费和 Token 费,总成本只需要 4分到5分半钱。
开发者如果只用裸模型 API,今天用 DeepSeek,明天就能改一行网址切去别家;
但当你的应用同时重度依赖它的搜索引擎排序、网页去噪清洗、文档解析和深度思考编排时,整套业务逻辑已经和它的云端底座长在了一起,迁移成本呈指数级飙升。
用极致的开放与微利的工具链做钩子,换取整个应用生态的深度锁死,这才是最高明的平台战略。

硅谷卖“奢侈品订阅”,中国造“AI 水电煤”
把视野再拔高一层,这场“半分钱风暴”折射出的,其实是中美两国 AI 产业截然不同的生存哲学与商业宿命。硅谷的 AI 巨头们背负着上千亿美元的算力资本开支,面对华尔街严苛的回报率审视,只能不断向产业链上游攀爬,通过 20 美元甚至 200 美元一个月的订阅制、高毛利的企业服务来维持体面——所以连一个搜索接口,他们都得标出 10 美元一千次的高价来保住利润。
 OpenAI CEO Sam Altman
而以
DeepSeek 为代表的中国 AI
力量,正把中国制造业最令世界生畏的“全产业链极致降本与商品化能力”,原封不动地复刻进人工智能时代——先用开源打平模型权重差价,再把 Token
打成白菜价,如今又把整套多模态 Agent 运行时直接做成了按滴计费的“水电煤”。
DeepSeek 内部负责应用底座的负责人崔添翼在发布当晚留下过一句话:“下一个超级 App 不必是面向所有人的一个超级 App,也可以是只属于你一个人的超级 App。”
当软件开发与运行的边际成本被压到几分钱时,软件工业延续了四十年的铁律正在松动——未来或许不再只有少数几个巨头垄断的、臃肿不堪的“国民级应用”,一个不懂代码的普通初中班主任、一个外贸业务员,花一个周末就能给自己捏出一个全世界只有他自己在用的专属软件,一个月运行成本还不到五块钱。
而此刻,大洋彼岸那些还在为“如何向用户多收 20 美元月费”绞尽脑汁的硅谷高管们,看着这张来自东方的“半分钱价目表”,恐怕得恨得牙痒痒。