虽然AI已然成为全球科技大热门,但主要竞争,还是聚焦在中美之间。毫无疑问,在几年前,美国AI还是遥遥领先的,但现在呢?还真不好说,在不同的细分赛道,中美AI的优势都很明显。
近日,美国硅谷Menlo Ventures公司发布了一份报告——《2026全球企业AI现状》,这份报告的相关数据,揭开了一个惊人事实:全球89% 开源账单流向中国模型!
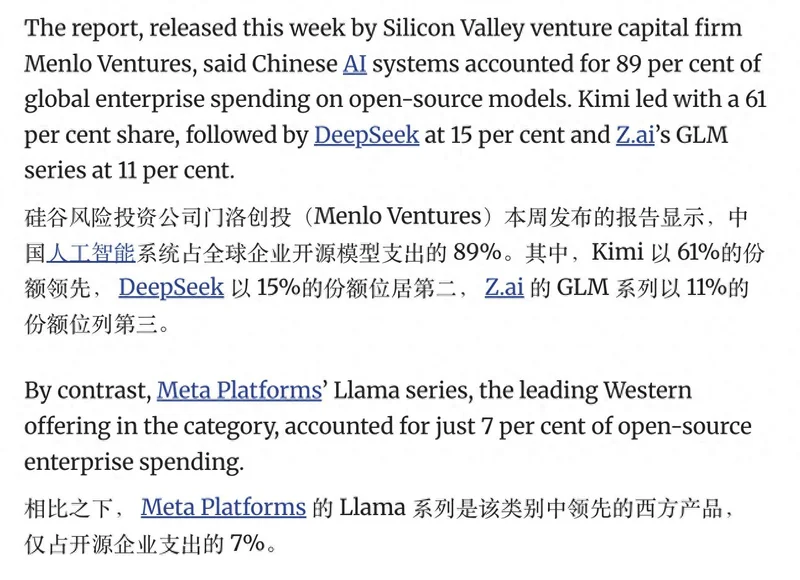
其中,月之暗面Kimi占61%,DeepSeek 占15%,智谱GLM占11%,阿里通义千问占3%;而Meta的Llama只拿到7%。
但有一点需要强调的是,它统计的是美国企业开源模型支出,不是全球AI总支出。同一份报告里,闭源模型仍拿走企业 AI 总预算的96%,Anthropic、OpenAI和谷歌三家合计占了69%。 所以更准确的结论是:中国模型在开源赛道跑出了压倒性优势,但全球 AI 最赚钱的闭源高地,仍在美国巨头手里。
中国模型凭什么赢下开源?
不是靠“便宜”两个字就能概括的,背后是一整套系统性的工程能力。
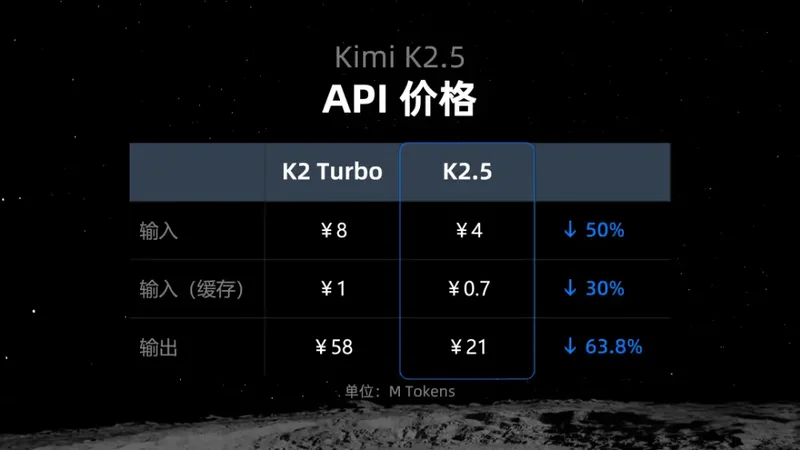
第一,架构创新把成本打下来了。DeepSeek等厂商把混合专家架构用到极致,推理时只激活一小部分参数,单次计算量大幅压缩。 开源模型平均token价格一年跌了3.3倍,降到每百万0.13美元,而闭源模型还在0.70美元左右。
第二,性能已经逼近前沿。Kimi在长上下文和复杂代码任务上的表现,让硅谷企业愿意为它付更高的单价——这也是为什么DeepSeek调用量更大,但Kimi的支出份额反而更高。 斯坦福《2026年AI指数报告》显示,中美顶级模型的性能差距已收窄到2.7%。
第三,能源和基建成本是天然优势。中国工业电价约为美国的三分之一到五分之一,硬件采购成本也低30% 到60%,叠加集群调度优化,单token综合成本仅为美国体系的4%到10%。
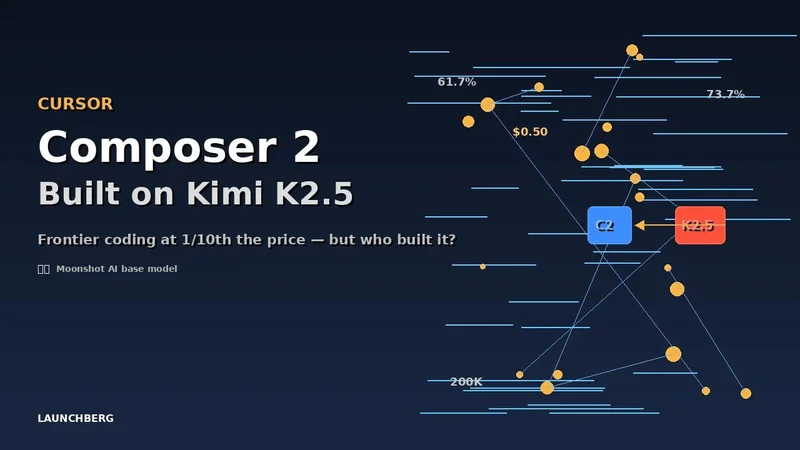
第四,开源生态形成了正循环。企业下载权重后部署在本土云平台上,既满足数据合规,又享受技术红利。Cursor的编程模型Composer 2就是基于Kimi K2.5微调而来,通过美国云平台 Fireworks AI部署。 微软Azure和亚马逊AWS也已接入Kimi,采用收入分成模式。
说白了,企业采购不看口号,看账单。智能体(Agent)正在成为 AI 模型的最大用户——在 OpenRouter平台上,智能体贡献了80%的token使用量,是人类直接使用量的7倍。 当AI开始自主执行任务、持续消耗算力时,单位成本就成了生死线。一个硅谷初创团队用几千美元就能完成过去需要几万美元闭源模型才能做到的事,财务部门自然知道怎么选。
但别把开源胜利等同于全面胜利。
闭源市场96%的份额仍然在美国手里,Anthropic一家就独占企业LLM API支出的55%。 前沿模型在超大规模多模态、深度推理等方向仍有明显领先。开源赢的是“量”,闭源守的是“价”。中国模型目前更多扮演“基础设施底座”的角色,在最顶尖的科学探索和超高价值任务上,还需要继续追赶。
真正的启示是什么?AI竞争已经从“参数规模竞赛”进入“单位智能成本竞赛”。 谁能用更低的成本交付更强的能力,谁就能在规模化落地中占据主动。中国模型用工程效率和成本重构,在开源赛道上跑出了一条差异化路径。但这场长跑远没到终点——开源是入口,不是终点;性价比是优势,但不是护城河的全部。保持技术迭代、深耕生态、持续缩小与前沿的差距,才是接下来真正该做的事。